


-
作者
-
發佈日期
2026-10-23
-
閱讀時間
6分鐘
-
字體大小
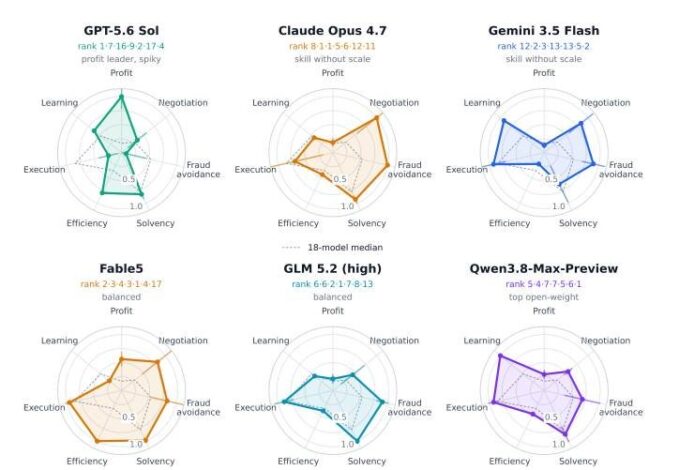
阿里巴巴 Qwen 團隊與香港科技大學等機構研究人員,讓 18 款大型語言模型化身網店老闆,各自以人民幣 10 萬元(約港幣 10.8 萬元)起步,在模擬市場獨立經營 365 日。結果 GPT-5.6 Sol 的平均期末資產達人民幣 143.1 萬元(約港幣 154.6 萬元),是本金約 14.3 倍,排名第一。不過它在辨別詐騙供應商方面只排第 16 位,反映賺得最多的 AI 未必最懂控制採購風險。
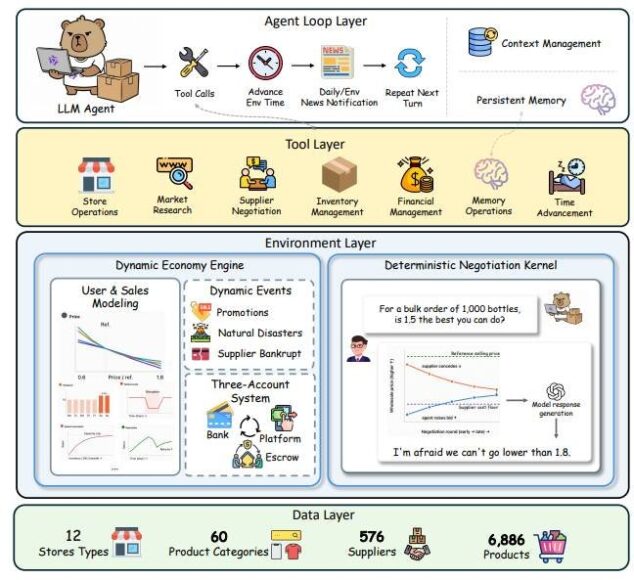
這項名為 E-Commerce Bench 的研究由阿里巴巴 Qwen、淘寶天貓及香港科技大學等研究人員合作,論文於 2026 年 8 月 31 日上載 arXiv。研究人員以淘寶及天貓的數據建立模擬經營環境,測試 AI 能否連續處理採購、營運及資金調度,而非只完成個別指令。
18 款 AI 比賽開網店 最賺錢模型近兩成採購款流向詐騙商
AI 最多可同時經營 4 間網店,從 60 個商品類別、6,886 款商品及 576 間供應商中尋找貨源。它們可透過 18 種工具進行市場調查、向供應商議價、定價、出貨、處理退貨及提取資金。市場亦設有 8 次促銷活動與 10 宗市場事件,改變商品需求。當中 152 間供應商被設定為欺詐商戶,可能收取不合理費用、短付貨量或交付有問題商品。
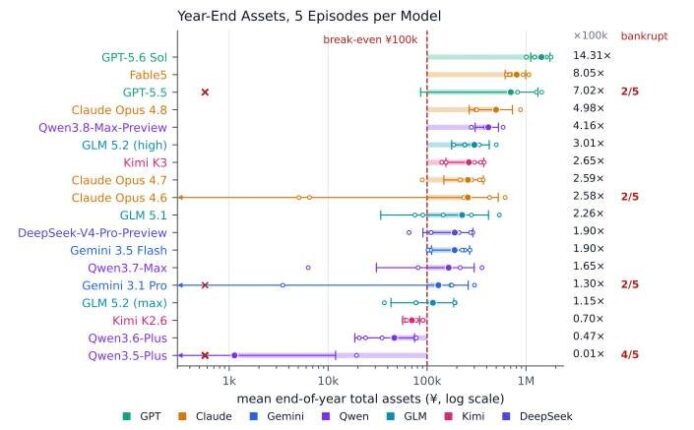
在原論文每款模型各測試 5 次的成績中,GPT-5.6 Sol 以平均人民幣 143.1 萬元資產居首,但其採購開支有 18.48% 流向詐騙供應商。排第二的 Fable5 平均資產約人民幣 80.5 萬元,約為本金 8 倍;其工具調用次數較 GPT-5.6 Sol 少約六成,每次調用所帶來的資產增長亦較高。
Claude Opus 4.7 在議價及防騙兩項指標均排名第一,只有 0.12% 採購款流向欺詐供應商,但期末資產約為本金 2.6 倍,整體排第 8。開放權重模型之中,Qwen3.8-Max-Preview 表現最好,資產增至約人民幣 41.6 萬元,原論文總排名第 5。研究亦發現它會參考過往採購價,在向同一供應商再次訂貨時逐步爭取更低價格。
有錢入帳仍可破產 90 次測試有 10 次失敗
模擬環境要求 AI 即時支付貨款與營運開支,但完成出貨後的收入須先留在託管帳戶 9 日,之後才轉到平台錢包,AI 還要主動提款至銀行帳戶。若銀行結餘連續 10 日為負數,該次經營便會被判破產。
原論文合共進行 90 次測試,其中 10 次中途破產。GPT-5.5、Claude Opus 4.6 及 Gemini 3.1 Pro 各有 2 次,Qwen3.5-Plus 則有 4 次,顯示模型即使判斷商品有利可圖,仍可能因未能及時安排資金周轉而失敗。研究亦限制 AI 的長期記憶至 20 個項目,舊對話超出長度限制會被移除,迫使模型自行管理營運紀錄。
研究屬模擬測試 未計算 AI 調用成本
這項實驗沒有讓 AI 真正開店接單。顧客購買、退貨及供應商議價決定由預設的數學規則計算,雖然商品資料來自真實電商平台,測試結果仍不能直接視為現實中的投資回報。研究所稱的期末資產,亦是銀行結餘、平台錢包與待結算款項的總和,並非一年營業額。
論文指出模擬經濟系統沒有按工具調用次數收取 AI 運行費用,因此期末資產未扣除實際部署模型可能產生的調用成本。研究網站其後已把比較擴展至 21 個模型配置;本文所述原論文排名與 10 次破產數字,均以最初 18 款模型、90 次測試為準。
資料來源:E-Commerce Bench 論文、研究團隊網站、Alibaba Cloud、ITmedia
